 FeQSoft
Mi van ebben a részben?
- Mit nyerhetünk és mit veszíthetünk a váltással?
- Excel: az 5.6 Sol az Astra előtt végzett
- Mit állít a gyártó a nehezebb feladatokról?
- Kép, videó, dokumentum: hol számít a modell?
- Lehet az újabb modell bizonyos dolgokban rosszabb?
- Hol nézhetünk meg más összehasonlításokat?
- Mit választanánk a bizonyítékok alapján?
Az 5.6 Sol az Astra elé került egy pénzügyi Excel-tesztben. Ez érdekes eredmény – de nem azt jelenti, hogy általában jobb nála. Négy modellt hasonlítunk össze: GPT-5.6 Sol, GPT-6 Sol, GPT-6.1 Sol és GPT-6 Astra. A pontszám mellé az időt, a költséget és a mérés korlátait is odatesszük.
Az első részben a modellek működését, a másodikban a gondolkodási fokozatokat és a krediteket tisztáztuk. Most arra válaszolunk: melyik modellt miért lehet érdemes használni? Forrásellenőrzés: 2026. október 9.; a változó rangsoroknál az alábbi táblázatok rögzített pillanatképet mutatnak.
Mit nyerhetünk és mit veszíthetünk a váltással?
Keskeny képernyőn a táblázat oldalra húzható.
| Modell | Miért lehet jó választás? | Mi szólhat ellene? |
|---|---|---|
| GPT-5.6 Sol | A vizsgált Excel-tesztben a négy közül a legjobb pontszámot érte el. | Azonos tokenmennyiség mellett drágább a 6 és 6.1 Solnál; nem minden területen vezet. |
| GPT-6 Sol | Kedvezőbb tokenár, és az Excel-pontszáma közel van az 5.6 Soléhoz. | Egyes összetett munkatesztekben a 6.1 Sol előnyt mutatott vele szemben. |
| GPT-6.1 Sol | A gyártói tesztek programozásban, dokumentumoknál és több lépéses munkánál javulást jeleznek. | A vizsgált Excel-tesztben a négy közül a legalacsonyabb pontszámot kapta, és a feladat végrehajtása a legtovább tartott. |
| GPT-6 Astra | A gyártó a legnehezebb munkákhoz ajánlja; számítógép-kezelési tesztjeiben erős eredményeket közölt. | A tokenára magasabb; a vizsgált Excel-tesztben nem végzett az 5.6 Sol előtt. |

Excel: az 5.6 Sol az Astra előtt végzett
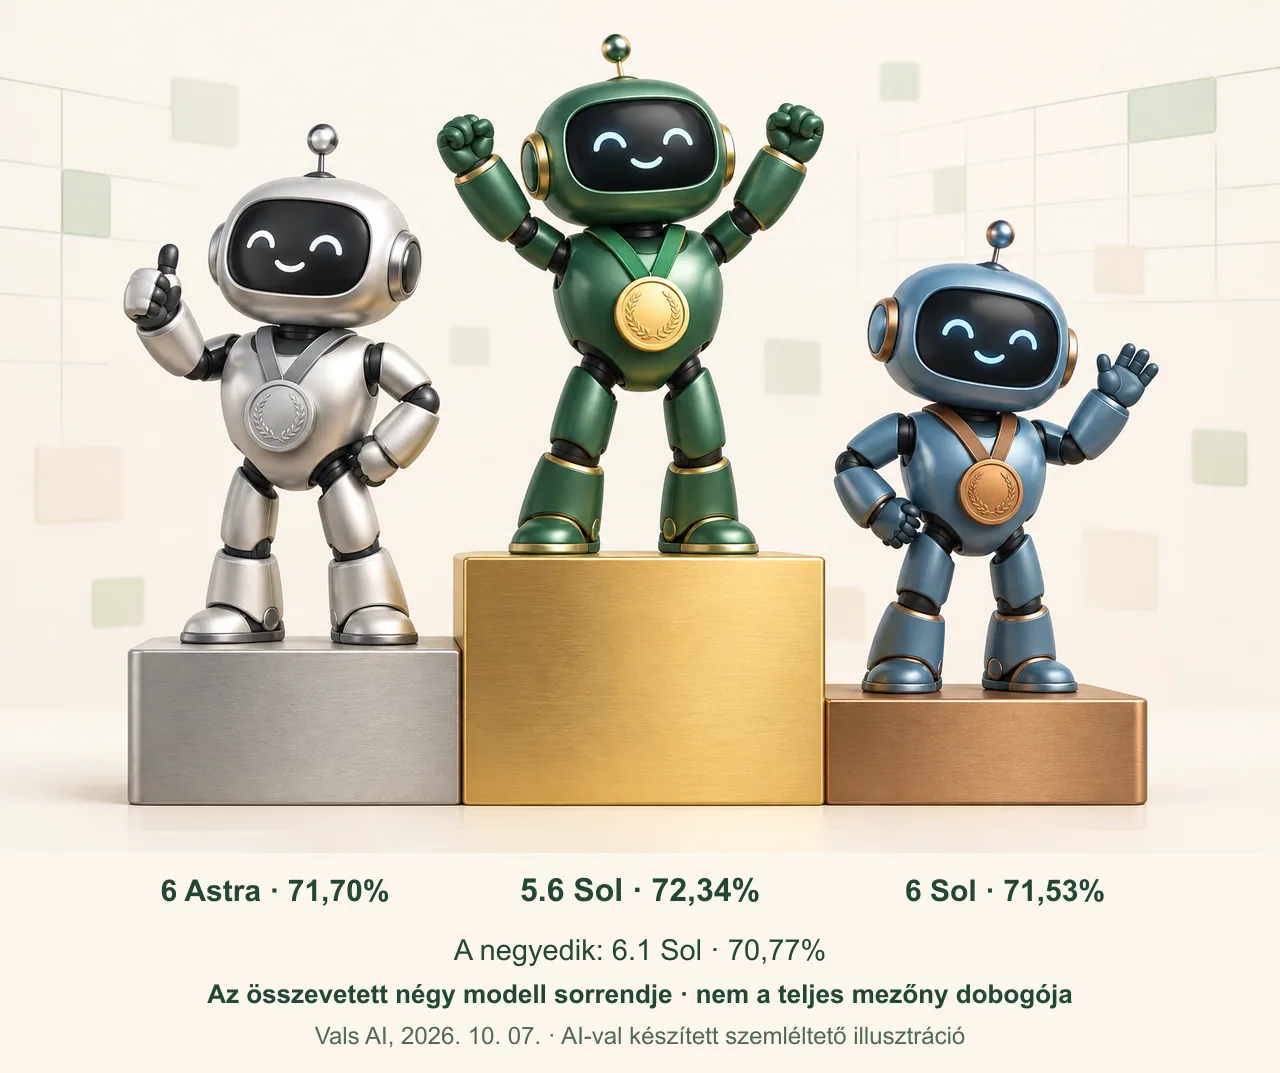
A Vals AI Excel Modeling Benchmark pénzügyi táblázatos feladatokat vizsgál. Az alábbi sorrend a 2026. október 7-én frissített eredményekből a cikkben összevetett négy modellre vonatkozik. Nem a teljes mezőny dobogója: más modellek ezeknél magasabb pontszámot is elértek.
Keskeny képernyőn a táblázat oldalra húzható.
| Modell | Pontszám | Átlagos költség / feladat | Átlagos idő / feladat |
|---|---|---|---|
| GPT-5.6 Sol | 72,34% | 6,01 USD | 9 perc 50 mp |
| GPT-6 Astra | 71,70% | 5,83 USD | 13 perc 24 mp |
| GPT-6 Sol | 71,53% | 1,28 USD | 10 perc 22 mp |
| GPT-6.1 Sol | 70,77% | 1,14 USD | 18 perc 28 mp |
A Sol megelőzte az Astrát ebben a tesztben: az 5.6 Sol előnye 0,64 százalékpont. Ez kis különbség, amelyből nem következik biztos általános Excel-fölény. Az 5.6 és a 6.1 Sol közti 1,57 százalékpontos eltérés sem jelenti azt, hogy az 5.6 a mindennapi Excel-munkákban bizonyítottan jobb.
A 6 és 6.1 Sol olcsóbban dolgozott, teljesítményük pedig a pontszámok alapján közel van a másik két modelléhez. A 6.1-nél ugyanakkor a feladat végrehajtása lassabb volt. A részpontozás nem hibátlan munkafájlok arányát mutatja.
A külön modellprofilokon a Vals AI bizonytalansági adatot is közöl: az 5.6 Solnál ±2,37, az Astránál ±2,48, a 6 Solnál ±2,35, a 6.1 Solnál ±2,71 százalékpontot. Ez azt jelzi, hogy a kapott pontszámot nem szabad hajszálpontosan biztos értéknek venni. A Sol–Astra különbség ezeknél jóval kisebb, a tartományok átfednek; ez nem támaszt alá egyértelmű, tartós fölényt. Az átfedés ugyanakkor nem bizonyítja, hogy a modellek egyformák.
A négy modellprofil Max gondolkodási fokozatot tüntet fel alapbeállításként, de jelzi, hogy egyes teszteknél eltérő beállítás vagy szolgáltató is lehet. Ezért nem nevezzük a rangsort minden körülményében azonos, teljesen kontrollált összehasonlításnak.

Mit állít a gyártó a nehezebb feladatokról?
Az OpenAI az új modelleket saját mérésekkel is bemutatja. Ezek hasznos adatok, de gyártói tesztek: a megadott feladatokra és körülményekre vonatkoznak, nem általános ígéretek minden felhasználónak.
Keskeny képernyőn a táblázat oldalra húzható.
| Feladat / teszt | Közölt eredmény | Mit jelenthet nekünk? |
|---|---|---|
| Kód javítása – DeepSWE v1.1 | A 6.1 Sol eredménye elérte az Astra szintjét, körülbelül ötödakkora költséggel; a 6 Solhoz képest 6,4 százalékponttal jobb. | Bizonyos összetett programozási munkákban a 6.1 Sol kedvező ár–eredmény arányt kínálhat. Nem minden kódjavításra érvényes szorzó. |
| Összetett PDF-munka – GDP.pdf | A 6.1 Sol az Astra eredményéhez közeli teljesítményt adott, körülbelül ötödakkora költséggel. | Hosszabb dokumentumos feladatnál lehet előnye; nem bizonyítja, hogy minden szkennelt magyar PDF-et jobban olvas. |
| Számítógép-kezelés – OSWorld 2.0 | Astra: 72,6%; 5.6 Sol: 65,7%. A gyártó időszimulációja körülbelül 40, illetve 75 percet jelzett. | A több lépéses, képernyőn végzett munka más eredményt mutathat, mint az Excel-pontszám. A szimuláció ideje nem a mi feladatunk garantált futásideje. |
A DeepSWE-összehasonlításban a 6.1 Sol a 6 Solnál alacsonyabb gondolkodási fokozattal is elérte a bemutatott előnyt. Ez mutatja, hogy az újabb modell javulása nem egyszerűen annyi, hogy mindig tovább dolgozik. A gyártó által megadott körülmények és a tesztben használt eszközök együtt számítanak.
Kép, videó, dokumentum: hol számít a modell?
Keskeny képernyőn a táblázat oldalra húzható.
| Feladat | Mi számít a modell mellett? | Mit tudunk most? |
|---|---|---|
| Dokumentum, PDF | Olvasható-e a szöveg, milyen hosszú a fájl, vannak-e táblák és ábrák, milyen eszköz olvassa be? | A GDP.pdf ad támpontot a 6.1 Solhoz. Nincs itt mind a négy modellre azonos magyar dokumentumteszt. |
| Excel | Tud-e valódi munkafájllal dolgozni és a képleteket ellenőrizni, vagy csak szöveget javasol? | A Vals AI fenti mérése pénzügyi feladatokra használható támpont, nem minden táblázatra. |
| Kép értelmezése | Képminőség, apró feliratok, a feladat és a képfeldolgozó eszköz. | A képi bemenet támogatása nem bizonyítja, hogy az egyik modell minden képet jobban értelmez. |
| Kép készítése | A külön képgeneráló eszköz és a képhez adott utasítás. | A beszélgetési modell segítheti a kérést, de egy Excel- vagy kódtesztből nem következik jobb generált kép. |
| Videó | Videóelemzésről, forgatókönyvről vagy videógenerálásról beszélünk-e, és melyik eszköz érhető el? | Ezek külön feladatok. A négy modell teljes videóképességére nincs ebben a cikkben azonos mérés. |
| Programozás, automatizálás | A fejlesztői eszközök, az engedélyezett műveletek és az ellenőrzés módja. | A DeepSWE és az OSWorld ad támpontot, de más-más munkát vizsgálnak. |

Magyarországon a ChatGPT és az API elérhető, de ettől egy adott képes, videós vagy Work/Codex-funkció még nem feltétlenül jelenik meg minden fiókban. A konkrét felületet, csomagot és területi hozzáférést kell ellenőrizni. Magyar jogi iratnál vagy céges dokumentumnál a nyelv, az aktuális jogszabály és az adatkezelés különösen fontos.
Lehet az újabb modell bizonyos dolgokban rosszabb?
Igen, ez lehetséges. A fejlesztés egyszerre több célt követhet: pontosabb utasításkövetést, jobb programozást, gyorsabb munkát vagy kedvezőbb költséget. Nem következik belőle, hogy minden részfeladat azonos mértékben javul. A tanítás részleteinek hiányában azonban nem tudjuk bizonyítani, hogy egy konkrét rosszabb válasz oka éppen egy kimaradt tanítási téma.
Van korábbi, gyártó által dokumentált példa is. Az OpenAI az o3 és o1 összevetésénél azt írta, hogy az o3 több állítást tett, és így több helyes, de több hibás vagy kitalált állítása is volt; a különbség a személyekről szóló PersonQA-tesztben jobban látszott. A pontos ok további kutatást igényelt. Ez nem GPT-6 teszt, de megmutatja, miért nem jelent az újabb név minden részterületen biztos javulást.
A mostani Excel-sorrend is figyelmeztető jel, nem bizonyíték általános visszafejlődésre. A kis pontkülönbség és a hiányosan egyeztethető körülmények miatt óvatosan kell értelmezni.
Hol nézhetünk meg más összehasonlításokat?
Keskeny képernyőn a táblázat oldalra húzható.
| Oldal | Mire jó? | Mire figyeljünk? |
|---|---|---|
| Vals AI | A fenti pénzügyi Excel-feladatok eredményére. | Nem teljes körű Excel-vizsga, és nem minden modell azonos gyakorlati környezetben fut. |
| ModelDial | Vegyes feladatok, gondolkodási fokozatok, idő és becsült költség összevetésére. | Az összesített pontszám feladatválasztástól és súlyozástól is függ. |
| ToneBench | Angol videóforgatókönyvek stílusának és minőségének mérésére. | Nem általános magyar szövegírási vagy emberi elégedettségi mérés. |
| Artificial Analysis | Többféle képesség, ár és sebesség áttekintésére. | Mindig az adott teszt módszerét és a pontos modellváltozatot nézzük. |
| Arena | Anonim válaszpárok közötti felhasználói választások megismerésére. | A kedvelt válasz nem feltétlenül a legpontosabb szakmai válasz. |
A felhasználói tapasztalat fontos, de nem azonos az ellenőrzött teljesítményteszttel. A rövid, kedves vagy hosszú válasz is lehet népszerű anélkül, hogy jobban számolna. Nem találtunk olyan, azonos feltételekkel készült magyar felhasználói felmérést, amely mind a négy modellre általános rangsort adna.
Mit választanánk a bizonyítékok alapján?
Excel-munkához az 5.6 Sol eredménye figyelemre méltó, költségre érzékeny választásnál viszont a 6 és a 6.1 Sol is erős jelölt. A kis pontkülönbség mellett a mérésben sokkal kedvezőbb költséget mutattak. A 6.1 lassabb futása akkor számít, ha fontos a gyors befejezés.
Összetett dokumentumos vagy programozási munkához a 6.1 Sol mellett szólnak a bemutatott gyártói tesztek. Nehéz, sok lépéses képernyős feladatnál az Astra eredménye lehet érdekes. Ezek feladathoz kötött támpontok, nem általános győzteshirdetések.
A jó választás az, amelyik a szükséges minőséget elfogadható idő és költség mellett adja. A legerősebbnek hirdetett modell akkor sem jó üzleti döntés, ha ugyanazt az eredményt drágábban kapjuk. Egyik modell sem helyettesíti a végső ellenőrzést. Céges használatnál az adatvédelem, a hozzáférési jogosultság, a szolgáltatói függőség és az automatizálás biztonsága is része a döntésnek.
Források
- Vals AI: Excel Modeling Benchmark – a 2026. október 7-én frissített rangsor, október 9-én ellenőrizve.
- OpenAI gyártói bemutatók: GPT-6.1 Sol; GPT-6 Astra.
- OpenAI o3/o4-mini System Card, 3.3: a hibás állítások korábbi példája.
- OpenAI: hozzáférés; Work/Codex díjazás; ChatGPT támogatott országok.
- A fenti összehasonlító oldalak módszertanát és aktuális modellváltozatát minden újabb döntésnél külön ellenőrizni kell.